Uso un agente de IA para programar a diario, y lo que más me ha costado no ha sido elegir modelo, sino decidir qué le dejo hacer solo y qué no. Mi conclusión después de unos meses es que el valor no está solo en la elección del modelo, sino también en las reglas y en el ciclo de revisión que montas a su alrededor.
Este artículo cuenta cómo lo tengo organizado en este mismo sitio web, incluidos los fallos y las fricciones. No es una guía universal: es lo que me funciona trabajando solo, en remoto, en proyectos grandes y pequeños, y con mucho cuidado por no perder el control de mi propio código, en el sentido de saber qué se está haciendo y qué no.
Un detalle importante para situarte: trabajo siempre en la terminal, tanto con Claude Code como con Codex. Todo lo que cuento aquí, incluido el paso de revisiones de uno a otro, ocurre en sesiones abiertas en la terminal, repartidas en varias pestañas.
El problema de partida
Un agente de IA es rápido y está dispuesto a seguir. Esa es la parte buena y también el riesgo: si le pides «termina esto», puede entender que también te toca commitear, desplegar, ordenar ficheros o tocar configuración que no le has pedido. Cuando algo sale mal, no sale mal despacio.
Así que antes de pensar en productividad me hice una pregunta más aburrida: ¿qué cosas no quiero que haga nunca por su cuenta, sin que yo se lo pida?
El CLAUDE.md como contrato
La respuesta vive en un fichero dentro del repositorio, CLAUDE.md, que el agente lee al empezar. Lo trato como un contrato de trabajo, no como documentación. Recoge cosas como:
- Instrucciones y estilo de código. Cómo se escriben los bloques de control, los estilos CSS, el idioma de los textos.
- Límites de acceso. El agente solo puede buscar y leer dentro del directorio del proyecto.
- Credenciales. No puede obtenerlas ni usarlas de ninguna forma, ni leyéndolas de un fichero ni reconstruyéndolas con un comando. Si una tarea las necesita, me las pide a mí o me pide que ejecute yo la consulta.
- Fuente de verdad única. Toda la información del proyecto vive en el repositorio. Si algo no está ahí, no existe.
Que viva en el repositorio importa más de lo que parece. Está versionado, lo puedo revisar como cualquier otro cambio y no depende de la memoria de ninguna herramienta.
Este es un fragmento real del CLAUDE.md de este sitio, abreviado:
## Reglas de trabajo

- **NUNCA** navegar, buscar ni leer archivos fuera del directorio raíz del proyecto […]
- **NUNCA** obtener ni usar credenciales (base de datos, APIs, servicios externos) de ninguna
  forma […]. Si una tarea requiere acceso a la base de datos u otro sistema con credenciales,
  pedir al usuario que las proporcione o que ejecute él mismo la consulta/comando.

## Uso de Git

> ⛔ **PROHIBIDO hacer commits sin orden explícita del usuario.**
>
> Terminar de implementar código no autoriza para hacer commit. Esperar siempre a que el
> usuario diga "haz commit" o equivalente […]
Dos de las reglas del contrato, tal como están escritas en el repositorio.
Eso sí, no todo reside en el CLAUDE.md. Se organiza en subdocumentos (como el documento de ciclo de versiones, adaptado a este proyecto web) que el propio CLAUDE.md indica cargar a voluntad, solo cuando la tarea los necesita. Así el fichero principal se mantiene corto y el agente no arrastra contexto que no toca. También uso skills, sin embargo, para casos concretos me resulta más eficiente personalizar subdocumentos, sin plantearme el nivel de abstracción que añaden las skills.
Un paso, una aprobación
El ciclo de versiones, que también está documentado en el repositorio, funciona así: el agente me guía, pero no avanza solo. Antes de cada paso me explica qué va a hacer y espera mi visto bueno. La aprobación de un paso no vale para el siguiente.
La secuencia es siempre la misma: spec, rama de la versión, subida de versión, desarrollo y pruebas, cierre con el changelog, despliegue y merge a main con su tag. Para este mismo artículo ya la he recorrido hasta la rama: primero la spec, después la rama 0.3.0-blog-ciclo-trabajo-ia y la subida de versión, cada una tras mi aprobación.
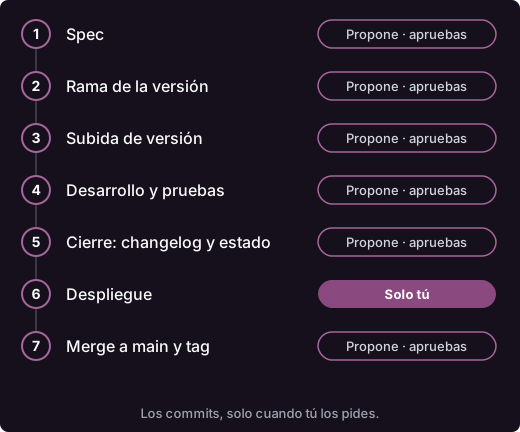
El ciclo completo. El despliegue es el único paso que ejecuto solo yo.
Lo que más agradezco de este ritmo es que no tengo que recordar el protocolo. El agente sabe en qué paso estamos y propone el siguiente.
Lo que el agente nunca hace solo
Hay tres cosas que dejo siempre en mis manos:
- Los commits. Solo los hace si se lo pido de forma explícita. Que haya terminado de implementar algo no le da permiso para commitear, y tampoco me lo pregunta: se lo pido yo cuando toca.
- El despliegue. Lo ejecuto yo con un script. El agente solo me avisa de que toca desplegar y, si se lo pido, me ayuda a diagnosticar la salida.
- El merge a
main.mainsolo contiene lo que ya está desplegado, probado y aprobado. El desarrollo y los hotfixes viven en la rama de la versión.
Con esto, lo peor que puede pasar en una sesión se queda en un cambio mal hecho en una rama, que se descarta o se corrige, y no llega a producción.
Revisar el diff
Que el agente sea rápido no me exime de leer lo que produce. Cuando reviso un cambio miro, sobre todo:
- Si se ha salido del alcance que le pedí.
- Si ha metido más abstracción de la necesaria para lo que se pedía.
- Si los tests prueban algo o solo existen para dar buena cara.
Es una lectura normal de un diff, pero sin la confianza que daría haber escrito el código yo mismo. Es justo donde el control importa más.
Una segunda opinión de otro modelo
Una pieza que añadí después es pedirle una revisión a otro modelo. Un modelo que revisa su propio trabajo tiende a dar por buenas las mismas suposiciones con las que lo escribió, y uno distinto ve cosas que el primero no.
Al principio usé el plugin de Codex para Claude Code, que permite lanzar la revisión desde la propia sesión con comandos como /codex:review o /codex:adversarial-review. Esta última es una revisión de solo lectura pensada para cuestionar las decisiones de diseño y las suposiciones del cambio, no solo para buscar errores, y admite un texto de enfoque (por ejemplo, condiciones de carrera o reintentos). Se autentica con una cuenta de ChatGPT o con una clave de API de OpenAI, y puede ejecutarse en segundo plano.
Funciona y es cómodo, pero a mí me quedaba corto por dos motivos. El primero: no podía mantener una conversación con Codex como la que tengo en su propia herramienta; el plugin lanza la revisión y devuelve el resultado, y para debatir un hallazgo tenía que salir de ahí. El segundo: elegir el modelo no era tan directo como en Codex (según la documentación, los flags --model y --effort están pensados para /codex:rescue, y para las revisiones lo habitual es tocar la configuración). Además, estos comandos son de solo lectura y devuelven la salida tal cual, de modo que esa revisión aparece directamente en la sesión del agente y yo prefería leerla antes que él.
Ahora lo hago a mano: le paso el cambio a Codex, leo yo su revisión, la filtro y solo entonces le paso al agente principal lo que merece la pena, o al revés, de uno a otro. Pierdo algo de comodidad, pero gano tres cosas:
- Trabajo con Codex en su propia herramienta, donde puedo conversar con él y elegir el modelo sin rodeos.
- Leo la revisión antes de que llegue al agente, sin que ya forme parte de su contexto.
- Puedo discutir o descartar hallazgos. Una revisión adversarial presiona por diseño: muchos hallazgos son ciertos, pero algunos son irrelevantes, casos extremos o escenarios muy difíciles de que ocurran con las condiciones reales del proyecto. Filtrar eso es parte de mi trabajo, y no quiero que el agente lo trate todo como igual de grave.
Hay además una razón de fondo para el tándem. Un modelo que no ha escrito el código lo mira sin las suposiciones del desarrollo, y un contexto viciado puede dar por buenas cosas que no lo son. Pero el contexto también ayuda: el agente que escribió el cambio y lee la revisión, sin haberla hecho él, ve de inmediato dónde encaja cada hallazgo. Por eso separo los papeles: revisa uno, corrige el otro. En mi experiencia, esa combinación resuelve los hallazgos mucho mejor que cualquiera de los dos por separado.
Eso sí, los hallazgos y las propuestas no viajan en un copy/paste continuo de una terminal a otra. Normalmente creo un documento de revisión y se trabaja sobre él, y ese documento también está bajo control de versiones, de modo que puedo ver todo el avance y las discusiones.
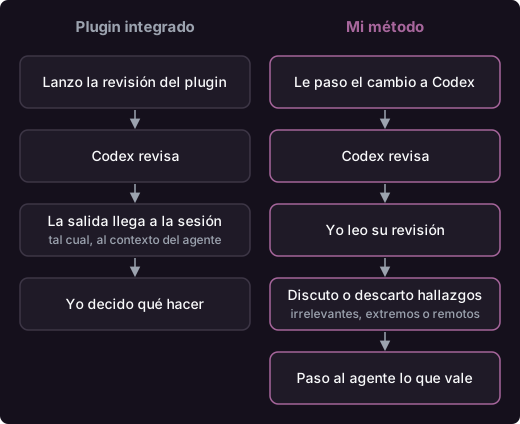
Revisión con el plugin integrado frente a mi método manual.
Lo que no funciona tan bien
- Es más lento al principio. Pedir aprobación en cada paso añade fricción, sobre todo en cambios pequeños.
- Las reglas hay que mantenerlas. Un
CLAUDE.mdque se queda desfasado pierde su valor. Es un fichero más del proyecto y requiere cuidado. - La revisión cruzada cuesta tiempo. No compensa en todos los cambios, y con una discrepancia no resuelta toca decidir igualmente a mano.
- Sigue sin sustituir al criterio propio. Ni las reglas ni la segunda opinión cambian que la responsabilidad del resultado es mía.
Soluciones que ya existen (y por qué sigo a mano)
La revisión cruzada entre modelos no es un problema nuevo y ya hay soluciones que lo automatizan. Existen skills y plugins de revisión multimodelo, como Star Chamber, de Mozilla.ai, o revmux, que lanzan varios modelos en paralelo y consolidan un informe, agrupando y verificando los hallazgos.
Yo mismo he valorado crear un skill propio con tres actores, un árbitro de por medio y una revisión mía como último recurso cuando no hubiera decisión. Pero tiene un inconveniente: perdería el seguimiento directo de lo que se está haciendo. Un informe no es lo mismo que enfrentarse a cada problema y decidir sobre él, y por ahora, con la responsabilidad del código que entrego a clientes, creo que hacerlo a mano es la mejor forma.
Lo que me llevo
Para mí lo importante son cuatro ideas: un contrato dentro del repositorio, un ciclo con aprobación en cada paso, límites claros sobre lo que el agente nunca hace solo y una revisión externa que yo mismo leo. El modelo concreto es casi lo de menos, porque se puede cambiar; las reglas son lo que hace que el trabajo sea predecible.
Una reflexión final: este modelo de trabajo solo puede entenderse con el estado de inteligencia de los modelos actuales. Lo más probable es que los modelos que vengan ya incorporen de serie estos procesos de revisión, haciendo que muchas de las revisiones manuales sean innecesarias y limitando la toma de decisiones a aspectos puramente de negocio.
Si te estás planteando incorporar un agente de IA en tu flujo de trabajo, mi consejo es empezar por escribir qué no quieres que pueda hacer. Y si quieres comentarlo, escríbeme: me interesa saber cómo lo tienes montado tú.