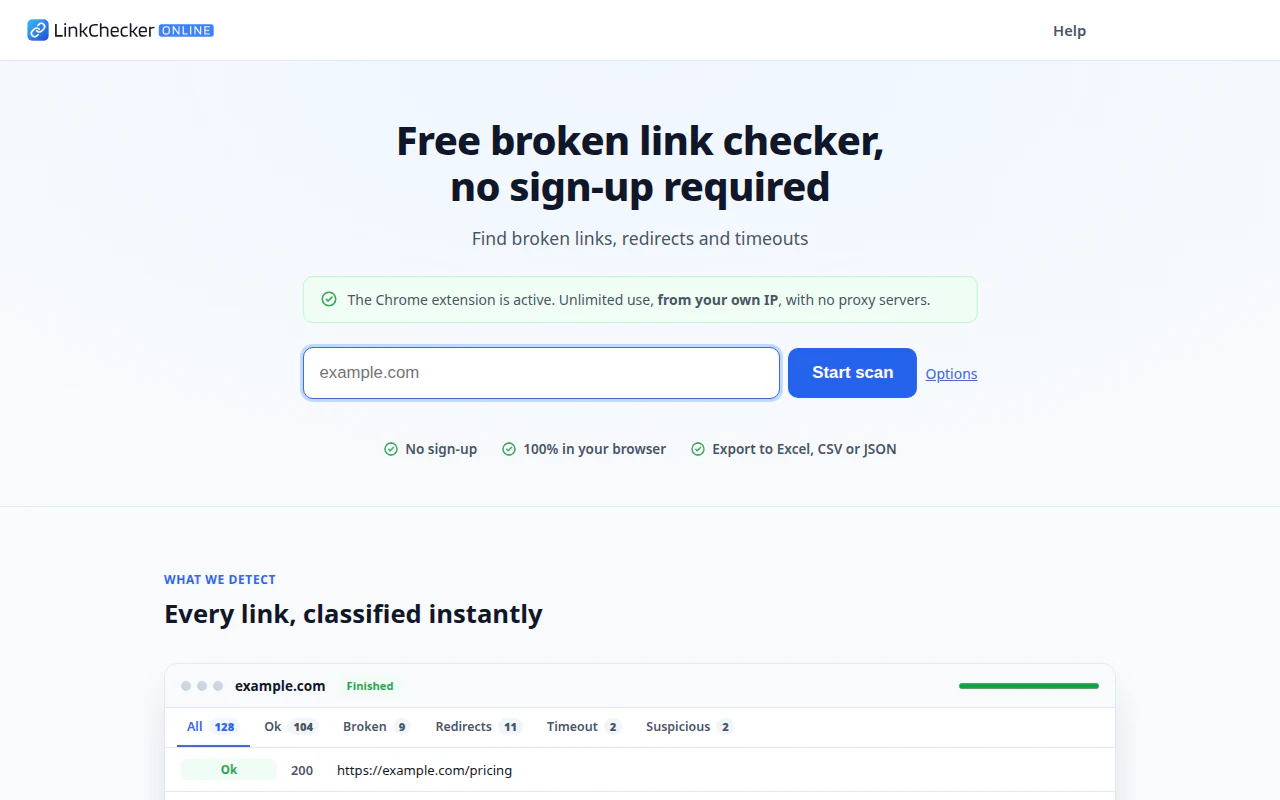
Quería una herramienta pública para comprobar enlaces rotos en una web. Ya existen muchas, así que me puse tres condiciones: que fuera gratuita y sin cuentas, que el rastreo ocurriera en el navegador del usuario (sin colas de trabajos en un servidor mío) y que quien necesitara más potencia pudiera saltarse los límites instalando una extensión de Chrome.
El resultado es linkcheckeronline.com. Este es el primero de dos artículos: aquí cuento cómo está montado y los obstáculos de diseño; en el segundo, los bugs que solo aparecieron en producción y las decisiones que tomé a propósito de no arreglar.
La idea de partida
Un comprobador de enlaces hace, en esencia, cuatro cosas: descarga una página, extrae sus enlaces, comprueba cada uno (¿responde?, ¿con qué código?, ¿redirige?) y sigue con las páginas del mismo dominio.
Lo habitual es hacerlo en un servidor. Yo quería lo contrario: toda la lógica (cola, deduplicación, clasificación, interfaz) en el cliente y un backend lo más fino posible. Sin base de datos, sin usuarios, sin nada que mantener. La arquitectura resultante es bastante peculiar:
- Un único Cloudflare Worker que sirve el frontend como static assets y expone unas pocas rutas
/api/*. - Un Durable Object para contar peticiones y limitar la concurrencia por sesión.
- JavaScript vanilla con módulos ES: sin framework y sin bundler para la aplicación.
- Un proyecto Astro independiente solo para el contenido estático (legal, ayuda, blog).
El primer muro: CORS
Antes de escribir una línea de interfaz ya tenía el problema que condiciona todo lo demás.
Desde una página web no puedes leer la respuesta de otro sitio. Si haces fetch("https://otra-web.com"), el navegador lo bloquea salvo que ese sitio envíe Access-Control-Allow-Origin. Y si usas mode: "no-cors" obtienes una respuesta opaca: estado 0 siempre y cuerpo ilegible. Para un comprobador de enlaces, que necesita justo el código de estado y el HTML, eso no sirve de nada.
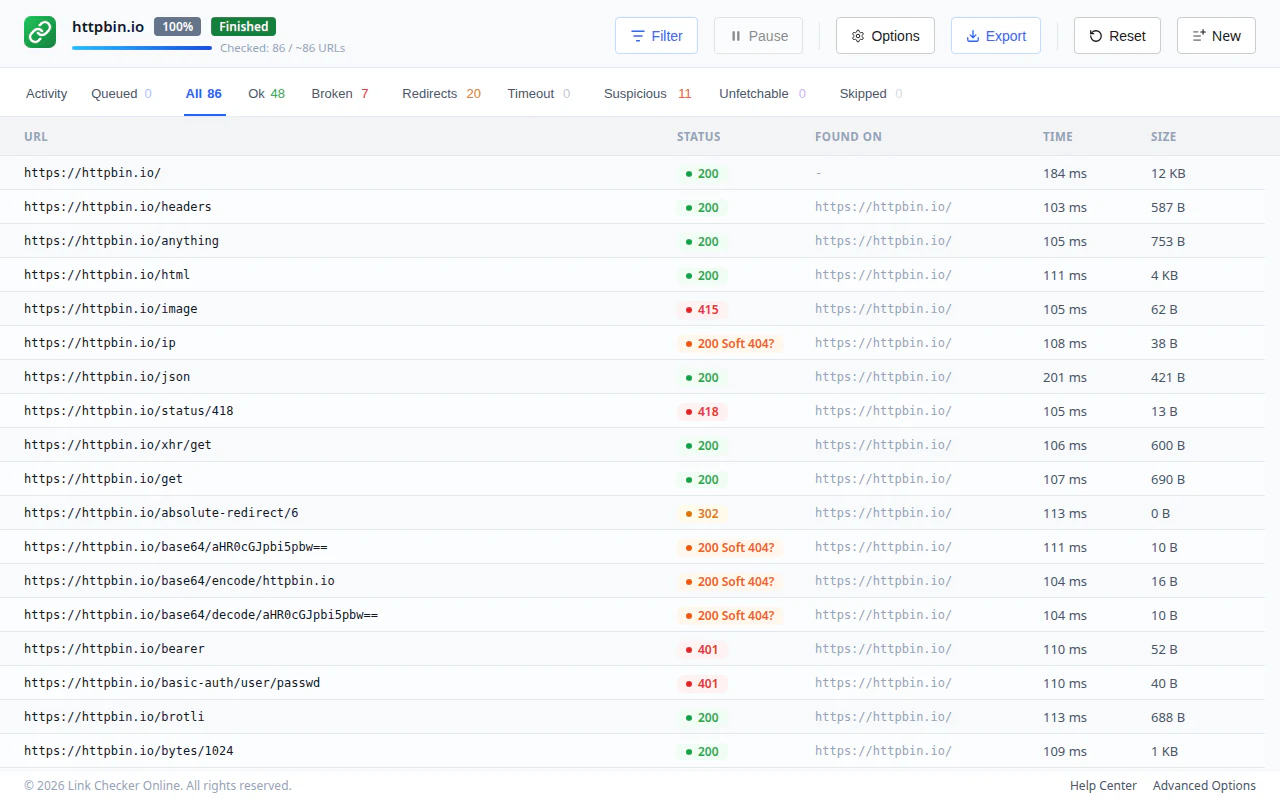
Por eso acabé con dos motores de fetch intercambiables detrás de una única función, fetchUrl():
| Proxy (por defecto) | Extensión de Chrome | |
|---|---|---|
| Quién hace la petición | El Worker de Cloudflare | El navegador del usuario |
| IP que ve el destino | La del Worker | La del propio usuario |
| Límite de URLs | 100, estricto | Sin límite de aplicación |
| Instalación | Ninguna | Extensión desde la Web Store |
El rastreador no sabe qué motor está usando: llama a fetchUrl() y recibe siempre la misma forma de respuesta (status, location, bodyText, contentType, durationMs…). Fue de las mejores decisiones del proyecto: cuando apareció la extensión, el resto del código no tuvo que enterarse.
El modo Proxy: poco backend, pero bien defendido
Un proxy abierto que hace peticiones a cualquier URL es un regalo para los abusadores, así que el backend, aunque fino, tiene varias capas:
- Cloudflare Turnstile (el CAPTCHA moderno, casi siempre invisible) para canjear un token.
- Un endpoint que valida ese token y devuelve un JWT de corta duración.
- Un segundo endpoint que exige el JWT, aplica un límite por IP y consulta al Durable Object antes de hacer la petición real.
- El Durable Object, indexado por el identificador del JWT, lleva el contador de 100 URLs y un semáforo de concurrencia.
Dos detalles pequeños que importaron. El Worker nunca sigue redirecciones hacia el destino (redirect: "manual"), porque quiero ver el 301 o el 302 tal cual: forman parte de lo que hay que informar. Y el tope de 100 URLs se impone en el servidor, nunca confiando en lo que diga el cliente.
Y una lección de Durable Objects: cada sesión crea una instancia nueva y no hay API para enumerarlas, así que su almacenamiento quedaría huérfano para siempre. La solución fue que cada instancia programe su propia alarma de borrado en el primer uso y haga deleteAll() cuando salta. La limpieza tiene que salir desde dentro, no desde un barrido externo.
La extensión de Chrome y las redirecciones opacas
Para el modo sin límites hice una extensión de Chrome. Con host_permissions sobre todos los orígenes, su service worker sí puede leer respuestas de otros dominios. Parecía fácil… hasta que probé las redirecciones.
Con redirect: "manual", el fetch() nativo del navegador no te da el 301: te da una respuesta opaqueredirect con status: 0 y sin cabeceras. El runtime de Cloudflare Workers, en cambio, sí expone el 3xx real. Dos mundos, dos comportamientos, y yo necesitaba que la clasificación fuera idéntica.
La solución fue observar la red desde fuera: dos listeners persistentes de chrome.webRequest (onBeforeRequest y onBeforeRedirect) que anotan el código de estado y la cabecera Location de cada salto, y un correlador que los empareja con la petición del fetch(). Cuando el fetch resuelve como opaqueredirect, consulto el correlador para recuperar lo que el navegador me había ocultado.
Lo difícil vino después. Con varias pestañas comprobando la misma URL a la vez, correlacionar solo por URL mezcla respuestas. Acabé correlacionando por initiator y requestId, y añadí una exclusión mutua por URL exacta y un semáforo de concurrencia por host (un máximo de peticiones simultáneas contra un mismo dominio, sumando todas las pestañas) para ser un «buen ciudadano» con el sitio rastreado.
El User-Agent que no se deja cambiar
Otro clásico: fetch() en un navegador ignora en silencio la cabecera User-Agent que le pongas. Yo quería identificarme como bot, con una URL que explica quién soy, y para lograrlo tuve que usar declarativeNetRequest.updateSessionRules() con una regla modifyHeaders, acotada a las peticiones iniciadas por la propia extensión para no tocar el resto de la navegación del usuario.
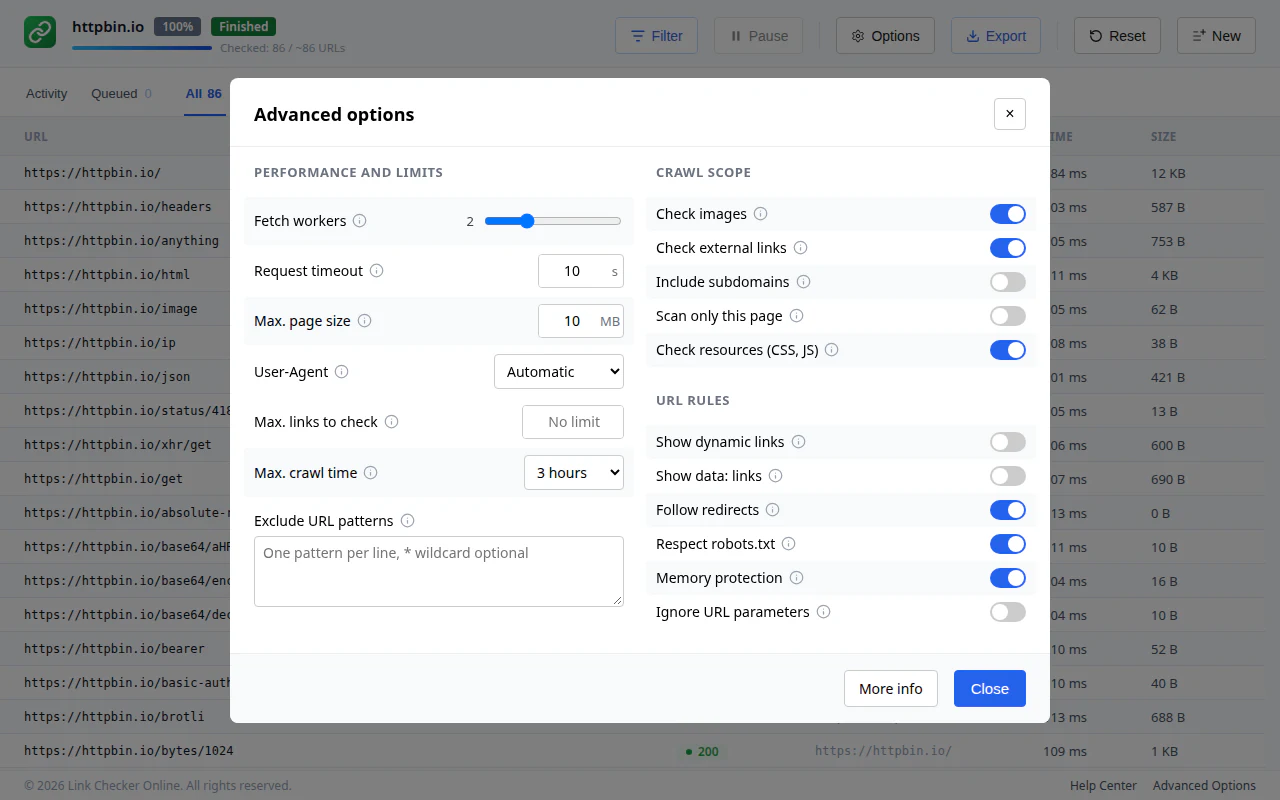
Y luego están los sitios que devuelven 403 (o el 999 de algunos) a cualquier bot. Para esos casos hay un modo Automático (el selector de User-Agent permite elegir otro): la primera petición siempre se identifica como bot y solo si el sitio la rechaza con un 403 o un 999 se hace un único reintento con el User-Agent del navegador, dentro de la misma petición y sin gastar cupo extra. El objetivo no es saltarse bloqueos, sino no dar por roto un enlace que un navegador normal sí abre.
Una frontera impuesta por la tienda
Publicar una extensión en la Chrome Web Store tiene un coste que no tiene una web: cada cambio exige subir versión y pasar otra revisión. Eso me obligó a trazar una frontera:
- Todo lo que pueda resolverse en la web o en el Worker, se resuelve ahí.
- La extensión es lo más simple y estable posible.
- Los fallos que solo se arreglarían en la extensión se anotan para un próximo envío en lugar de parchearse sobre la marcha.
Es una disciplina incómoda al principio, pero me ha ahorrado más de una revisión innecesaria.
Qué viene en la segunda parte
Hasta aquí, el diseño. Lo que más se aprende, sin embargo, está en lo que falló: un botón que no hacía nada solo en producción, un rastreo que «terminaba» al reanudarlo, caracteres rotos por la codificación y un par de decisiones de no arreglar algo a propósito. Lo cuento el viernes en la segunda parte.
Mientras tanto, si quieres probar la herramienta, está en linkcheckeronline.com. Y si encuentras un enlace roto que no detecta, me interesa mucho saberlo.